Ollama
Sprachmodelle
Da mein Server keine GPU hat, bin ich bei der Auswahl der Sprachmodelle eingeschränkt.
| Name | Typ | Kontext | Dateigröße | Performance | Qualität | Veröffentlicht | Herausgeber |
|---|---|---|---|---|---|---|---|
| deepseek-r1:8b-llama-distill-q4_K_M | ? | ? | ? | ? | Deepseek (MIT) | ||
| deepseek-coder-v2:16b-lite-base-q2_K | ? | ? | ? | ⭐⭐ | ⭐ | ? | Deepseek (MIT) |
| deepseek-r1:8b-llama-distill-q4_K_M | ⭐ (6.2 Tokens/s) | ⭐⭐ | Deepseek (MIT) | ||||
| gemma3:1b | ⭐⭐⭐⭐ (30.7 Tokens/s) | ⭐⭐ | |||||
| qwen3.5:9b | Text, Image | 256K | 6.6GB | - | - | 2026-03 | Alibaba |
| qwen3.5:4b | Text, Image | 256K | 3.4GB | - | - | 2026-03 | Alibaba |
| qwen3.5:2b | Text, Image | 256K | 2.7GB | ⭐⭐ (9.6 Tokens/s) | ⭐⭐⭐ | 2026-03 | Alibaba |
| qwen2.5-coder:3b | Text | 32k | 2.7GB | ⭐⭐⭐⭐ (38.2 Tokens/s) | ⭐⭐ | 2025-07 | Alibaba |
Installation und Konfiguration
Die Leute vom Projekt „Open WebUI“ machen es extrem einfach, seinen Chatbot zum Laufen zu bringen. Im Grunde erstellt man einfach eine neue docker-compose.yml-Datei wie die im Beispiel unten und startet das Ding wie üblich per Befehl „docker compose up -d“. Das war's – kein Scherz!
services:
  chat:
    container_name: chat
    image: ghcr.io/open-webui/open-webui:ollama
    volumes:
      - ./ollama:/root/.ollama
      - ./open-webui:/app/backend/data
    restart: unless-stopped
    #ports:
    #  - 8080:8080
    networks:
      caddy:
networks:
  caddy:
    external: true
Wie in meiner Beispieldatei zu sehen ist, habe ich die Netzwerkkonfiguration angepasst und zudem meinen Reverse Proxy caddy so konfiguriert, dass der Zugriff auf chat.handtrixxx.com auf meinen neuen Container zeigt. Wie der folgende Screenshot zeigt, kann man auf „Sign up“ klicken, um sich selbst einen neuen Benutzeraccount als Administrator anzulegen.
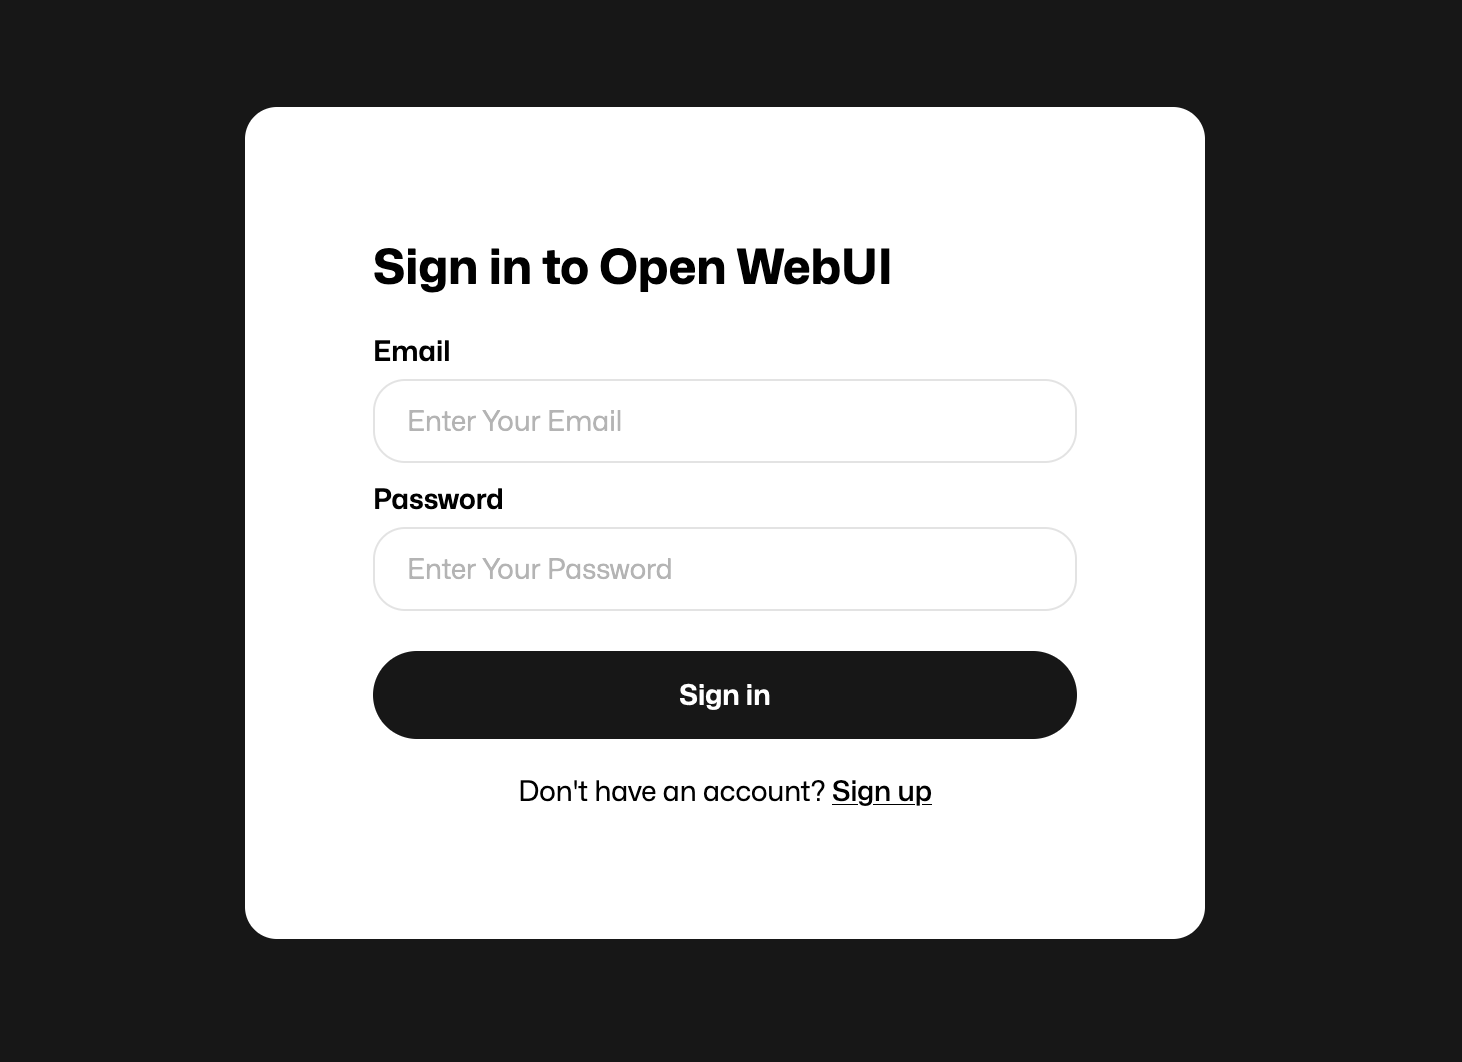
Nach dem Login sind nur noch zwei Schritte zu tun, um die KI-Chats zu starten. Zuerst sollte man ins Admin-Panel gehen und dann unter „Admin settings“ die Registrierung für andere Nutzer deaktivieren, damit andere Benutzer nicht einfach einen Account auf der Instanz anlegen. Dann muss man in den Einstellungen im Reiter „Models“ ein oder mehrere Sprachmodelle herunterladen. Es gibt plenty – aus vielen kann man wählen. Eine Übersicht ist verfügbar unter https://ollama.com/library. Man ist fertig, und wie man sieht, muss es nicht länger als 5 Minuten dauern, wenn man etwas Erfahrung mit Docker und dem Einrichten von Tools allgemein hat.
Kosten
Da alles, was ich eingeführt und beschrieben habe, auf Open-Source-Software basiert, fallen keinerlei Kosten oder Lizenzgebühren an. Klasse, oder? Aber zu sagen, dass es komplett kostenlos ist, stimmt auch nicht ganz, denn man muss die Kosten für den Server tragen, falls man ohnehin keinen „hat“ 🙂.
Performance
Wie erwähnt würde eine dedizierte Grafikkarte die Antwortzeiten des Chatbots enorm beschleunigen. Da ich es nur auf der CPU laufen lasse wie in meinem Beispiel, nahm jede Generierung einer Antwort für einige Sekunden die gesamte CPU-Leistung in Anspruch (und ich habe viel). Das Ganze fühlt sich damit ein wenig wie die frühen Versionen von ChatGPT an. Das ist kein Drama, aber definitiv spürbar.
Fazit
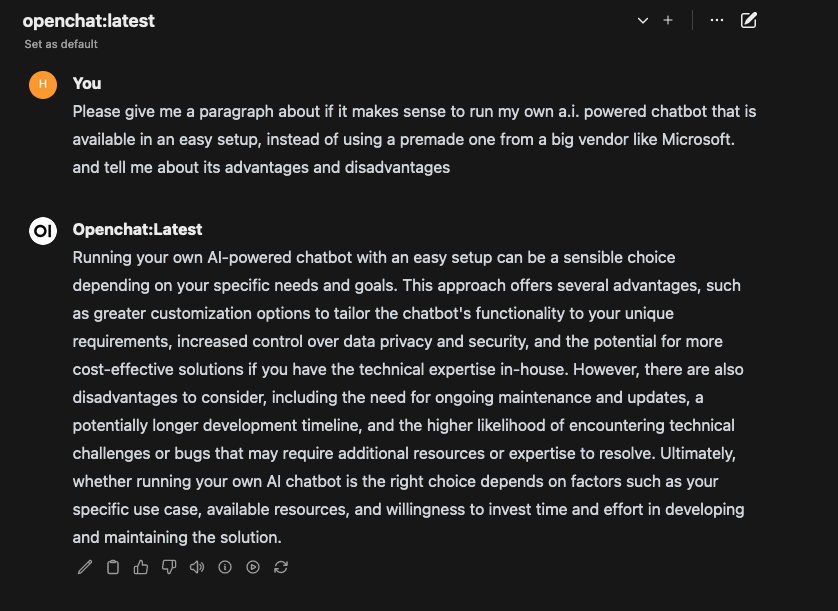
Als Fazit habe ich das OpenChat-Sprachmodell selbst auf meinen Prompt antworten lassen: